Ton LLM te noie sous l'info ? 4 formats pour alléger ta charge mentale (testés sur un vrai sujet)
Tu poses une question simple à ton LLM. Il te répond par trois écrans de texte. Des titres, des sous-titres, des listes à puces dans des listes à puces, un tableau, une conclusion qui résume ce que tu viens de lire, et une question pour te proposer d’aller plus loin.
Tu scrolles. Tu survoles. Et à la fin, tu as retenu une phrase. Peut-être deux.
Le problème qu’on me remonte le plus souvent
Dans les formations et les accompagnements que je donne sur l’IA pour les équipes tech, il y a une remarque qui revient presque à chaque fois. Pas sur les hallucinations, pas sur la sécurité, pas sur le prix.
« L’IA me donne trop d’informations. Je suis épuisé à force de lire ce qu’elle me sort. »
Les variantes sont nombreuses :
- « Je lui demande une explication, il me fait un cours magistral. »
- « En fin de journée, relire tout ce que l’agent a produit, c’est plus fatigant que de coder. »
- « Je finis par ne plus lire, et je valide en diagonale. »
Cette dernière phrase est la plus inquiétante. Parce que valider en diagonale ce qu’un agent a fait sur ton code, c’est exactement le moment où les bugs passent.
Et je ne vais pas faire semblant : je suis passé par là. Je me suis surpris plus d’une fois à faire défiler une réponse interminable en cherchant la seule ligne qui m’intéressait. Ou à relancer une question parce que j’avais décroché au milieu de la première réponse.
Pourquoi c’est si fatigant
Il y a une asymétrie brutale dans notre relation aux LLM : produire du texte ne leur coûte presque rien, le lire nous coûte beaucoup.
Notre mémoire de travail est minuscule. Les recherches en psychologie cognitive estiment qu’on manipule activement autour de quatre éléments à la fois. Au-delà, on sature. C’est ce que la théorie de la charge cognitive appelle la charge extrinsèque : l’effort qu’on dépense non pas à comprendre le sujet, mais à décoder la façon dont il est présenté.
Un mur de texte, même bien écrit, impose au lecteur de tout faire lui-même : repérer la structure, construire une image mentale, faire tourner le processus dans sa tête. Le sujet n’est pas plus dur qu’avant. C’est le format qui pèse.
Et ça empire avec les agents. Plus ils font de travail à notre place, plus notre rôle se déplace vers la supervision et la compréhension de ce qu’ils ont produit. Autrement dit, la lecture devient le goulot d’étranglement.
L’idée de Karpathy : changer de format, pas de modèle
C’est exactement ce point qu’Andrej Karpathy a soulevé dans un thread sur X il y a quelques jours. Son constat : on va passer de plus en plus de temps à essayer de comprendre ce que produisent les modèles. Donc autant leur demander des formats qui se comprennent mieux.
Il propose une gradation, chaque niveau étant présenté comme « encore mieux » que le précédent :
- Écrire en ASD-STE100, une langue contrôlée inventée pour la documentation de maintenance aéronautique.
- Demander un schéma plutôt qu’un texte.
- Demander une page web en HTML, interactive.
- Demander une vidéo explicative façon 3Blue1Brown, avec narration.
Et il ajoute une idée que je trouve très juste : maintenant que le code est devenu abondant, on peut se permettre de générer des artefacts jetables, sur mesure et parfois énormes (une appli web, une vidéo) juste pour comprendre un truc. Des choses qui n’auraient eu aucun sens à produire avant.
Vu sous l’angle de la charge mentale, c’est une piste sérieuse. Au lieu de te demander de reconstruire l’image dans ta tête, on demande au modèle de faire ce travail à ta place.
J’ai voulu vérifier si ça tenait vraiment la route.
Le protocole
Même sujet pour les quatre formats : comment fonctionne un harnais d’agent de code, c’est-à-dire le programme qui entoure le modèle dans Claude Code, OpenCode, Codex ou Kilo Code.
Le sujet n’est pas choisi au hasard. C’est typiquement le genre de question qui déclenche une réponse fleuve quand on la pose à un LLM. Tout le monde utilise un agent au quotidien, et très peu de gens savent vraiment décrire ce qu’il se passe. Qui décide ? Quand est-ce que ça s’arrête ? Pourquoi est-ce qu’il oublie des trucs au bout d’une heure ?
Si tu veux la version longue et classique, j’avais déjà décortiqué le sujet dans Anatomie d’un harness.
Tout a été généré avec Claude, dans une seule conversation. Pour chaque format, je me suis posé une seule question : combien d’effort il me faut pour comprendre ?
Petit rappel du concept à expliquer, pour que tu puisses juger :
- Un LLM seul ne sait faire qu’une chose : recevoir du texte, renvoyer du texte.
- Le harnais lui donne des outils (lire un fichier, le modifier, chercher, lancer une commande).
- Tout tourne dans une boucle : contexte → modèle → appel d’outil → résultat → contexte, jusqu’à ce que le modèle réponde sans demander d’outil.
- Le contexte est limité, donc le harnais le compacte quand il sature.
- Les permissions filtrent chaque appel, et les sous-agents permettent d’explorer sans polluer le contexte principal.
Allez, quatre rounds.
Round 1 : l’anglais des mécaniciens d’avion
C’est quoi, l’ASD-STE100 ?
L’ASD-STE100 (pour Simplified Technical English) est une norme née dans l’aéronautique. Le but : qu’un mécanicien dont l’anglais n’est pas la langue maternelle, fatigué, à 3 h du matin sur un tarmac, ne puisse pas mal comprendre une procédure.
Autrement dit, c’est une norme conçue dès le départ pour réduire la charge mentale du lecteur. Pour y arriver, elle impose des règles assez brutales :
- un dictionnaire de mots autorisés, avec un seul sens par mot ;
- 20 mots maximum pour une phrase d’instruction, 25 pour une description ;
- voix active et impératif obligatoires ;
- une seule action par phrase ;
- des avertissements normalisés (
WARNING,CAUTION) avec la conséquence explicite.
Concrètement, « Prior to commencing the deployment, it is imperative that… » devient « Before you start the deployment, do these steps: ». Adieu le blabla.
Le résultat
AGENT HARNESS: HOW IT OPERATES

1. GENERAL
An agent harness is a program that operates around a large language model (LLM).
The LLM can only read text and write text.
The LLM cannot open files. The LLM cannot run commands.
The harness gives tools to the LLM.

2. TOOLS
Each tool does one operation:
- Read: shows the contents of a file.
- Edit: changes the contents of a file.
- Grep: finds text in files.
- Bash: runs a command in the terminal.

3. THE LOOP
The harness operates in a loop. Each cycle has these steps:
1. The harness sends the context to the LLM.
2. The LLM sends a response. The response is text or a tool request.
3. If the response is a tool request, the harness does the tool operation.
4. The harness adds the result to the context.
5. The harness goes back to step 1.
If the response is text only, the loop stops. This text is the final answer.
The LLM does not make a full plan before it starts. It selects the next step in each cycle.

4. CONTEXT
The context contains all the data that the LLM can use:
- The system instructions.
- The project file (for example, AGENTS.md).
- The conversation.
- The results of the tools.
The context has a maximum size. Tool results make it full quickly.
When the context is almost full, the harness makes a summary of the old data.
The harness then removes the old data and keeps the summary.

5. PERMISSIONS
WARNING: THE LLM CAN MAKE REAL CHANGES TO YOUR FILES AND YOUR SYSTEM.
SET THE PERMISSIONS BEFORE YOU START THE HARNESS.
- Read operations: the harness does them automatically.
- Edit operations and commands: the harness can ask for your approval.
- Dangerous commands: the harness can stop them.

6. SUBAGENTS
For a large task, the agent can start subagents.
Each subagent has its own loop and its own empty context.
A subagent does its task and sends back only a summary.
Thus, the context of the main agent stays small.
Ce que ça fait à ta charge mentale
Comparé à une réponse classique de LLM, c’est un soulagement immédiat. Pas de reformulation, pas d’introduction, pas de conclusion qui répète le reste. Chaque phrase porte une seule information, et chaque mot veut dire une seule chose. Ton cerveau n’a rien à trier.
La section 3 est la plus parlante : la boucle agentique devient une procédure numérotée. Tu pourrais presque l’implémenter en lisant le texte ligne par ligne. Et le WARNING sur les permissions dit en deux lignes ce qu’une réponse classique aurait noyé dans un paragraphe prudent.
Le revers, c’est que c’est aride. On ne se fatigue pas à trier, mais on se fatigue à lire quelque chose d’aussi sec. Et c’est en anglais par construction, ce qui rajoute de la charge pour un lecteur francophone. Karpathy lui-même dit qu’il demande parfois du « 80 % STE » pour adoucir. C’est probablement le bon réglage au quotidien.
Charge mentale : faible pour trier, moyenne pour lire.
Là où ça brille : une doc de référence, une spec, un fichier AGENTS.md, ou un prompt système. Un texte qu’on ne peut pas mal interpréter, c’est aussi exactement ce qu’on veut donner à un autre modèle.
Round 2 : le schéma
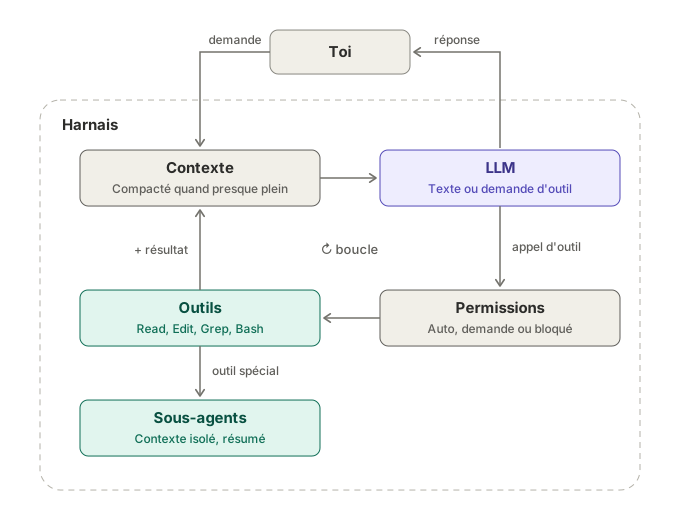
Deuxième format : on arrête d’écrire, on dessine.
Ce que ça fait à ta charge mentale
C’est le format qui fait le plus de travail à ta place. Avec un texte, c’est toi qui construis l’image mentale du système. Ici, elle t’est donnée toute faite. Les cinq briques, le sens des flèches, la place des permissions entre le modèle et les outils, et les sous-agents présentés pour ce qu’ils sont vraiment : un outil comme un autre, juste un peu spécial.
Le schéma dit en une image ce que le texte STE dit en quarante lignes. Et surtout, tu peux y revenir en une seconde, sans relire.
Mais il a un angle mort, et il est de taille : il ne montre pas le temps. Le petit « ↻ boucle » au centre fait ce qu’il peut, mais rien ne te fait sentir que cette boucle tourne cinq, dix, trente fois pour une seule demande. Pour imaginer ça, ton cerveau doit encore faire tourner le schéma tout seul. C’est précisément là que la charge remonte.
Un schéma, c’est une carte. Et une carte ne te dit pas combien de temps dure le trajet.
Charge mentale : la plus faible pour comprendre la structure, plus forte pour comprendre le comportement. Là où ça brille : poser le modèle mental en début de formation ou d’article, servir de référence qu’on garde sous la main.
Round 3 : la page web interactive
Troisième format, et c’est là que ça devient intéressant. J’ai demandé une page HTML, et Claude a produit un simulateur pas à pas.
Tu choisis un scénario, tu cliques sur « Suivant », et tu vois à chaque étape :
- le nœud actif de la boucle qui s’allume ;
- la trace des appels, comme dans un vrai terminal ;
- le compteur de tours de boucle ;
- la jauge de contexte qui se remplit.
Le point clé pour notre sujet : tu ne reçois qu’une seule information à la fois. Une étape, une phrase d’explication, un changement visible. C’est toi qui décides quand passer à la suivante.
Essaie par toi-même, c’est fait pour ça :
Ouvrir le simulateur en plein écran
Les trois scénarios, et ce qu’ils révèlent
Scénario 1 : « Corrige le test qui échoue »
Le modèle lance npm test, lit l’échec, ouvre src/auth.ts, trouve que l’expiration du token n’est jamais vérifiée, et demande à modifier le fichier.
Et là, le simulateur s’arrête. C’est toi qui décides.
- Si tu autorises, le harnais applique la modification, le modèle relance les tests pour vérifier son propre travail, tout passe, et il répond. Cinq tours de boucle.
- Si tu refuses, le refus revient au modèle… comme n’importe quel résultat d’outil. Il en tient compte et te répond sans toucher au code, en t’expliquant le correctif à appliquer toi-même. Quatre tours.
C’est le meilleur moment de toute l’expérience. Lire que « le refus est renvoyé au modèle », c’est une abstraction de plus à stocker. Cliquer sur Refuser et voir le modèle changer de plan au tour suivant, ça ne demande aucun effort de mémorisation. Tu l’as vu, c’est acquis.
Scénario 2 : « Nettoie le dossier de build »
Le modèle tente un rm -rf ./*. Le harnais le bloque sans même te demander : la commande tombe sous une règle d’interdiction. Le blocage revient au modèle, qui resserre sa commande en rm -rf dist. Celle-là est destructive mais ciblée, donc le harnais te laisse trancher.
Un seul scénario, et tu as vu les trois niveaux de permission : automatique, sur demande, bloqué. Sans liste à retenir.
Scénario 3 : « Où est gérée l’authentification ? »
Le modèle délègue l’exploration à un sous-agent. Une deuxième jauge de contexte apparaît. Le sous-agent fait un grep sur 37 fichiers, en lit 6, et sa jauge grimpe à plus de 70 %. Puis il renvoie un résumé de deux lignes… et la jauge de l’agent principal bouge à peine.
J’ai expliqué les sous-agents des dizaines de fois avec des phrases. Deux jauges côte à côte font le job mieux que toutes mes phrases.
Ce que ça fait à ta charge mentale
C’est le format qui découpe le mieux l’information. Le texte te donne tout d’un coup, le schéma aussi. Le simulateur, lui, te donne une seule chose à la fois, au rythme que tu choisis. Exactement ce qu’il faut à une mémoire de travail qui sature au-delà de quatre éléments.
Et surtout, tu comprends en agissant. Le schéma te donne la carte, le simulateur te met au volant. Ce qu’on a provoqué soi-même, on n’a pas besoin de le mémoriser : on s’en souvient.
Seule limite : il faut avoir envie de cliquer. Ça demande un peu d’engagement au départ.
Charge mentale : la plus faible des quatre, parce qu’elle est étalée dans le temps et pilotée par toi. Là où ça brille : formation, onboarding, atelier. Tout contexte où la personne a cinq minutes et l’envie de manipuler.
Round 4 : la vidéo explicative
Dernier format, celui sur lequel Karpathy est le plus optimiste : une vidéo explicative générée de A à Z, dans le style de 3Blue1Brown.
Pour ceux qui ne connaissent pas : 3Blue1Brown est la chaîne YouTube de Grant Sanderson. Il y explique des maths par l’intuition visuelle, sur fond sombre, avec des animations fluides où chaque couleur relie un symbole à ce qu’il représente. (Et le nom vient de ses yeux : un de ses iris est en partie brun.)
Ce qu’il y a dedans
Deux minutes et quelques, découpées en neuf séquences : le modèle seul, les outils, la boucle (un point lumineux qui fait trois tours avant de sortir vers la réponse), l’exemple du test qui échoue, la fenêtre de contexte qui se remplit puis se compacte, les permissions, les sous-agents, et un récap final sous forme d’équation :
agent = LLM + outils + boucle + contexte + garde-fous
Les coulisses (la partie drôle)
La vidéo elle-même est sortie très vite. C’est le son qui a été l’aventure.
Version 1 : narration avec la synthèse vocale du navigateur. Sur le papier, élégant, zéro clé d’API. En pratique, sur mon iPhone… rien. Aucun son. Le navigateur intégré bloquait la voix.
Version 2 : correction pour iOS, qui exige que le son démarre dans le geste de l’utilisateur. Toujours rien.
Version 3 : changement de stratégie. Claude a installé Piper, un moteur de synthèse vocale open source, dans son environnement d’exécution, a généré la narration de chaque séquence avec une voix française libre, a allongé les séquences dont la phrase dépassait, puis a assemblé le tout en une piste MP3 intégrée directement dans la page. L’animation se cale désormais sur le temps de l’audio, donc tout reste synchronisé.
Là, ça a marché.
Ce qui m’a marqué, ce n’est pas la vidéo. C’est que pour livrer un truc qui fonctionne, le modèle a fini par monter son propre petit studio de doublage en local. C’est très exactement le « trouve une alternative gratuite qui tourne en local » que suggérait Karpathy.
La voix Piper reste un peu synthétique, avec quelques nasales approximatives. Le script complet, découpé par séquence avec les timecodes, était fourni avec la vidéo pour pouvoir la narrer soi-même.
Ce que ça fait à ta charge mentale
La vidéo combine deux canaux : l’image et la voix. C’est un vrai avantage cognitif. Tu n’as plus à lire et à regarder en même temps : tu écoutes l’explication pendant que tes yeux suivent le mouvement. Et comme le schéma, l’animation fait pour toi le travail de visualisation… mais cette fois, avec le temps en plus. La boucle tourne vraiment sous tes yeux.
En deux minutes, tu as vu la boucle tourner, le contexte se remplir, la porte des permissions s’ouvrir et se fermer.
Le revers : le rythme est imposé. Si tu décroches dix secondes, la vidéo ne t’attend pas. Et elle est plus coûteuse à produire, surtout à cause du son.
Charge mentale : faible, tant que le rythme te convient. Là où ça brille : LinkedIn, introduction de webinaire, teaser de formation. Tout ce qui doit capter l’attention avant d’expliquer en profondeur.
Le tableau récap
| Format | Charge mentale | Ce qu’il fait comprendre | Son angle mort | Je l’utiliserais pour… |
|---|---|---|---|---|
| Réponse LLM classique | Élevée | Un peu de tout, dans le désordre | Tout est à trier par le lecteur | Plus grand-chose, honnêtement |
| Texte STE | Faible à trier, moyenne à lire | La procédure exacte, sans ambiguïté | Aride, en anglais | Doc, spec, AGENTS.md, prompt système |
| Schéma | Très faible pour la structure | Le système en un coup d’œil | Ne montre pas le temps qui passe | Poser le modèle mental |
| Page interactive | La plus faible | Le comportement, en le provoquant | Demande un peu d’engagement | Formation, onboarding, atelier |
| Vidéo | Faible si le rythme convient | L’intuition, en deux minutes | Rythme imposé, son délicat | Réseaux, teaser, intro de webinaire |
Ce que j’en retiens
1. Le problème n’est pas le contenu, c’est l’emballage
Les quatre formats racontent exactement la même chose. Ce qui change, c’est qui fait le travail de mise en forme : toi, ou le modèle. Une réponse classique te laisse tout le travail. Un schéma ou un simulateur le fait à ta place.
Et c’est une bonne nouvelle : la surcharge d’information n’est pas une fatalité. C’est un réglage.
2. Le bon format dépend de ce que tu veux faire après
La bonne question n’est pas « quel est le meilleur format ? » mais « qu’est-ce que je dois faire de cette information ? »
- L’appliquer sans me tromper ? Texte contraint.
- Me repérer dans un système ? Schéma.
- Comprendre un comportement ? Interactif.
- Avoir envie d’en savoir plus ? Vidéo.
3. Les formats se combinent mieux qu’ils ne s’opposent
La combinaison qui m’a le plus convaincu : le schéma pour poser la carte, puis le simulateur pour la parcourir. C’est exactement ce que je vais tester dans mes prochaines sessions de formation Clean Agentic Dev, justement auprès de ceux qui me parlent de cette fatigue.
4. Le logiciel jetable change la donne
Il y a deux ans, personne n’aurait codé un simulateur interactif pour expliquer un concept à une équipe. Trop long, trop cher, pour un usage unique. Aujourd’hui, c’est une demande dans un chat.
Karpathy a raison : la contrainte n’est plus de produire l’artefact, c’est d’avoir l’idée de le demander. On a pris l’habitude de réclamer du texte aux LLM parce que c’est ce qu’ils savaient faire au début. Cette habitude nous coûte de l’énergie tous les jours.
Les prompts à garder sous le coude
Pour passer à la pratique dès demain, voici les formulations que j’utilise maintenant :
Explique-moi [sujet] en 80 % ASD-STE100 : phrases courtes, voix active,
une idée par phrase, aucun paragraphe d'introduction ni de conclusion.

Au lieu d'un texte, fais-moi un schéma de [sujet] : 5 à 7 blocs maximum,
des flèches pour les flux, en SVG.

Crée une page HTML interactive qui me fait comprendre [sujet] pas à pas :
une seule étape visible à la fois, un bouton Suivant, et des scénarios
où je peux faire des choix et voir les conséquences.

Crée une vidéo explicative style 3Blue1Brown de 2 minutes sur [sujet],
sans narration, et donne-moi le script découpé par séquence avec les timecodes.
Et un dernier, valable pour toutes tes conversations :
Avant de répondre, donne-moi la réponse en 3 lignes maximum.
Je te demanderai les détails si j'en ai besoin.
Ce dernier prompt ne paie pas de mine. Mais c’est probablement celui qui a le plus réduit ma propre fatigue au quotidien.
Petite mise en abyme pour finir
Tout ça, c’est un agent qui a expliqué comment fonctionnent les agents. Pour la vidéo, il a littéralement suivi la boucle qu’il décrivait : essayer, lire l’échec, changer d’approche, recommencer. Trois tours de boucle pour avoir du son.
Le modèle n’avait pas de plan. Il avait un harnais.
Et toi, tu ressens aussi cette fatigue face aux réponses des LLM ? Quelles astuces tu utilises pour l’alléger ? Raconte-moi, je suis preneur. Et si tu veux recevoir les prochaines expériences de ce genre, la newsletter est juste en dessous.